SenseNova U1 نموذج جديد يجمع بين الفهم والتصميم في أداة واحدة
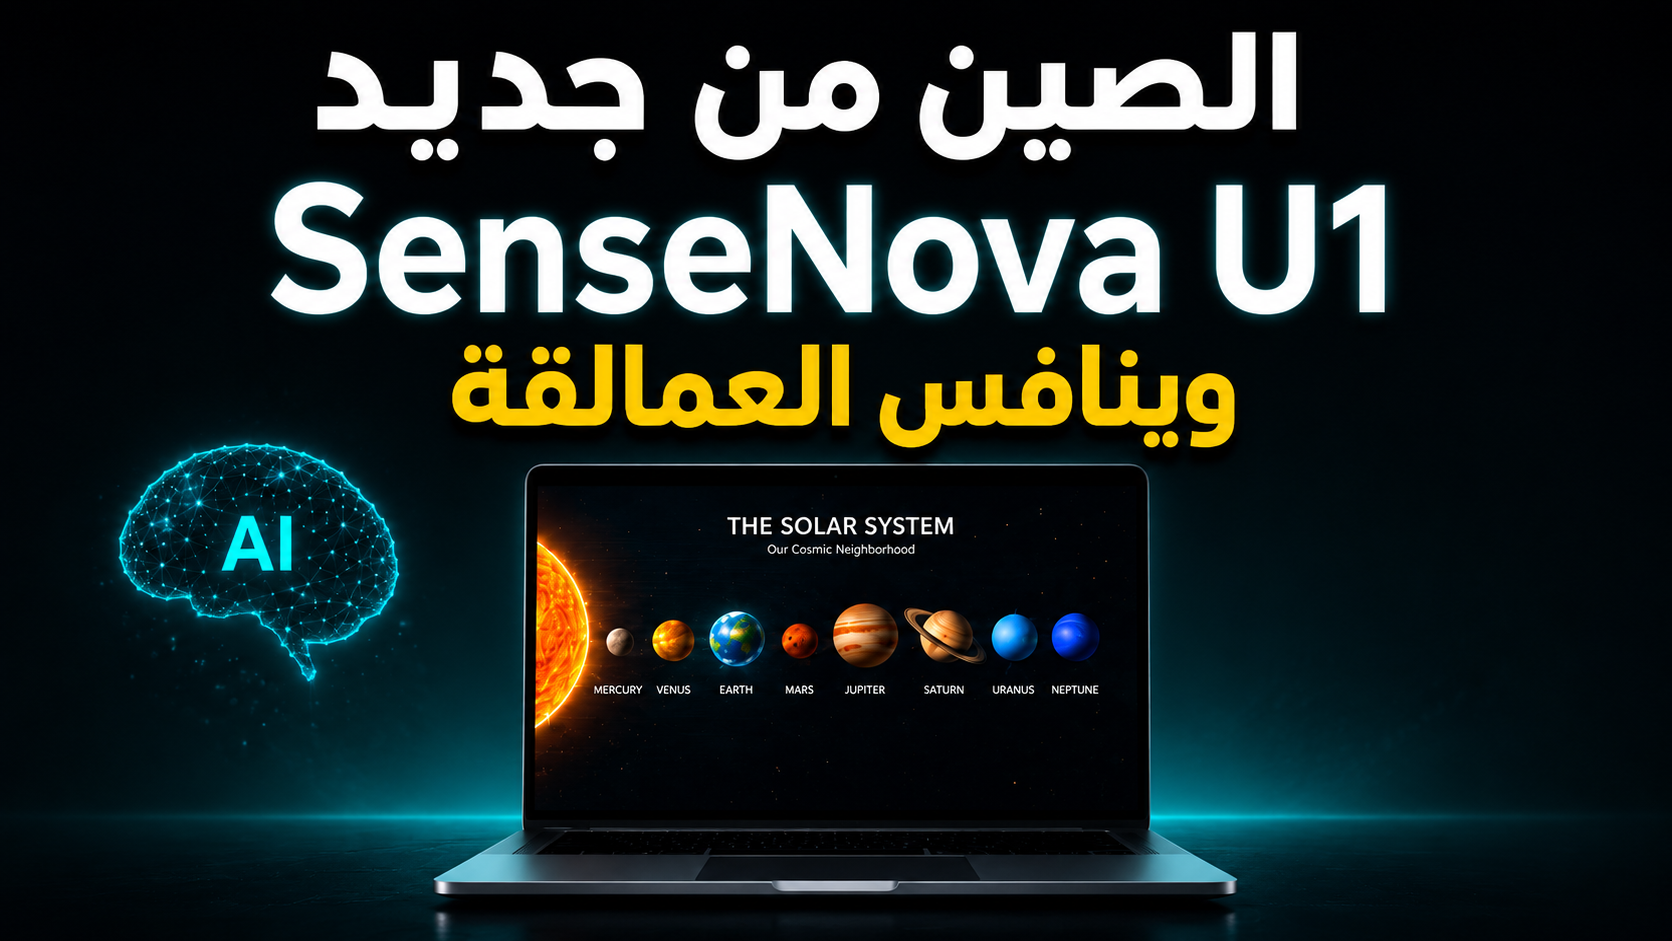
يشهد مجال الذكاء الاصطناعي تطورًا سريعًا، خصوصًا مع ظهور النماذج متعددة الوسائط التي لا تكتفي بفهم النصوص فقط، بل تستطيع التعامل مع الصور وتوليد محتوى بصري أيضًا. ومن بين هذه النماذج يأتي SenseNova U1، وهو نموذج يجمع بين فهم النصوص والصور وإنتاج التصميمات داخل تجربة واحدة.
في هذا الفيديو نستعرض فكرة النموذج وطريقة عمله، مع نظرة على صفحة المشروع على GitHub للتعرف على أبرز إمكانياته. من أهم هذه القدرات فهم الصور، الإجابة على الأسئلة البصرية، توليد الصور، تصميم الإنفوجرافيك، بالإضافة إلى ميزة Interleaved Generation التي تتيح الجمع بين النص والصورة في نفس النتيجة بشكل مترابط.
بعد ذلك ننتقل إلى تجربة عملية داخل SenseNova Studio / SenseNova-U1-Fast، حيث نحاول إنشاء إنفوجرافيك احترافي عن أعظم الابتكارات في تاريخ البشرية، ثم نجرب تصميمًا آخر عن المجموعة الشمسية. وخلال التجربة نحلل جودة التصميم، وضوح النصوص، ودقة المعلومات الموجودة داخل النتائج.
كما نقارن مخرجات SenseNova U1 مع أدوات أخرى مثل Geminiو ChatGPT/Claude، لمعرفة مدى قوة النموذج من حيث شكل التصميم، تنظيم المعلومات، ودقة البيانات. فالسؤال الأهم هنا: هل يستطيع SenseNova U1 منافسة أدوات الذكاء الاصطناعي الكبرى فعلًا؟
تواصل شركات الذكاء الاصطناعي سباقها لتقديم نماذج أكثر قوة في مجال توليد الصور وتعديلها، وهذه المرة تعود Meta إلى الواجهة من خلال نموذجها الجديد Muse Image داخل Meta AI. النموذج يلفت الانتباه لأنه لا يركز فقط على إنشاء صور من وصف نصي، بل يقدم أيضًا أدوات للتعديل، وإعادة بناء المشهد، وتغيير العناصر، ودعم استخدامات عملية…
أصبحت نماذج الذكاء الاصطناعي تتطور بسرعة كبيرة، ومع كل إصدار جديد يبدأ السؤال الأهم: هل يمكن للمستخدم العادي تجربة هذه القدرات بدون اشتراك مدفوع؟ في هذا الفيديو نناقش تجربة عملية لاستخدام Claude Sonnet 5 داخل الخطة المجانية من Claude، ونوضح هل النموذج متاح فعلًا، وما حدود استخدامه، وهل يستحق التجربة أم لا. الفكرة المهمة أن…
شهد عالم الذكاء الاصطناعي خلال الفترة الأخيرة حالة من الجدل بعد ظهور حديث واسع حول تقييد الوصول إلى نموذج Fable 5، وهو ما أثار تساؤلات كثيرة بين المستخدمين والمهتمين بالتقنية: لماذا لم يعد النموذج متاحًا للجميع؟ وهل الأمر مجرد قرار تقني عادي، أم أننا أمام مرحلة جديدة من التحكم في أقوى نماذج الذكاء الاصطناعي؟ في…
أحد أقوى الإضافات لـ Qwen-Image-Edit-2511 هو Multiple-Angles LoRA، وهو امتداد مصمم خصيصًا لمنحك القدرة على توليد صور من زوايا متعددة لنفس الكائن أو المشهد. LoRA (Low-Rank Adaptation) هو نوع من الإضافات التي تُدرَّب على تحسين قدرات النموذج الأساسي، وهنا يتم تدريب LoRA على بيانات ثلاثية الأبعاد عالية الجودة باستخدام تقنية Gaussian Splatting لتوليد 96 وضعية…
يشهد عالم الذكاء الاصطناعي منافسة قوية بين النماذج الكبرى، ولم يعد السباق مقتصرًا على الإجابة عن الأسئلة أو كتابة النصوص فقط، بل أصبح التركيز الآن على النماذج القادرة على تنفيذ مهام طويلة ومعقدة، مثل البرمجة، تحليل البيانات، إنشاء العروض التقديمية، التعامل مع الملفات الكبيرة، وبناء تطبيقات أو محاكاة تفاعلية من خلال أوامر نصية بسيطة. ومن…
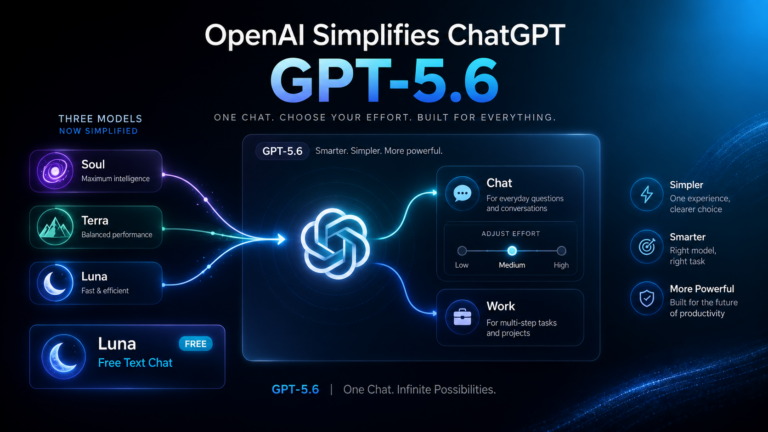
أجرت OpenAI تغييرات مهمة على طريقة استخدام نماذج GPT-5.6 داخل ChatGPT، والهدف الأساسي منها هو تبسيط تجربة المستخدم وتقليل الحيرة التي كانت تنتج عن تعدد النماذج ومستويات التفكير المختلفة. في السابق، كان مستخدم ChatGPT يستطيع الاختيار بين ثلاثة نماذج رئيسية من GPT-5.6، وهي Soul وTerra وLuna، إلى جانب إمكانية تحديد مستوى الجهد أو التفكير الذي…